

Comment j’ai donné une spec à Claude pour qu’il écrive et exécute son propre plan de test E2E, dans un vrai navigateur, avec un rapport visuel à la clé.
L’idée en deux phrases
On décrit un site à tester dans un simple fichier texte. Claude l’explore tout seul, planifie une liste de tests, les exécute dans un vrai navigateur via Playwright, puis produit un rapport visuel avec un verdict honnête pour chacun : 🟢 OK, 🔴 bug, ou 🟠 « à vérifier ».
Le mot-clé, c’est autonome mais auditable : Claude fait le travail, mais chaque verdict est appuyé sur une observation et une capture d’écran. Pas de magie noire.
À la fin de ce tutoriel, tu auras un dossier qui enchaîne plan → test → rapport en une commande. Compte 15 minutes de mise en place.
Prérequis
- Claude Code installé et connecté, c’est lui qui orchestre tout.
- Le dossier qa-agent-shared à télécharger ici (les commandes et les scripts, prêts à l’emploi). Tu peux simplement l’ajouter au fichier racine de claude code.
- Demande à claude d’ouvrir le fichier qa-agent-shared (valide les demandes de claude)
Tu n’as pas besoin de savoir coder, ni de maîtriser Node.js ou Playwright. Node.js tourne en coulisses, et c’est Claude Code qui pilote le navigateur pour toi. Concrètement : tu télécharges le dossier, tu ouvres Claude Code dedans, et tu lui parles.
Étape 1 – Le contenu du dossier
Tu n’as rien à construire : le dossier qa-agent est déjà organisé autour de commandes Claude Code (des fichiers Markdown dans) et de deux scripts. Voici ce qu’il contient :
qa-agent/
├── .claude                  # /preparer, /cible, /plan, /test, /rapport, /agent-qa
├── cible.md                 # CE QU'ON VEUT TESTER (le seul fichier qu'on remplit)
├── lancer.mjs               # enchaîne plan → test → rapport
├── construire-rapport.mjs   # génère le rapport HTML
└── captures/                # captures d'écran (preuves)
Le principe directeur : tout est en Markdown lisible par un humain. Pas de JSON dans les fichiers de travail. N’importe qui peut relire le plan et les résultats sans savoir coder.
Le branchement du navigateur est géré par Claude Code. Il détecte tout seul son besoin et te demande simplement, la première fois, d’autoriser le « serveur Playwright ». Tu acceptes, et c’est fait. Pareil pour Node.js
Étape 2 – Dire ce qu’on veut tester
Tu ne remplis aucun fichier à la main. Tu lances l’agent, par exemple en écrivant « Je veux lancer l’agent QA » (ou la commande /agent-qa), et c’est Claude Code qui s’occupe de tout
Il fera d’abord toutes les vérifications techniques nécessaires pour s’assurer qu’il dispose bien de tous ce dont il a besoin, puis il te posera des questions :
- Quel site veux-tu tester ? (l’URL)
- Quelle(s) attente(s) / spec(s) ? (ou « aucune » pour un test « à l’aveugle »)
- Combien de tests souhaites-tu ? (indicatif)
cible.md, tu n’as pas à y toucher. Le résultat ressemble à ceci :## URL du site
https://www.monsite.com/
## Ce que je veux tester
Aucune spec : test « à l'aveugle ». Découvre le site et couvre les fondamentaux.
## Nombre de tests souhaité (indicatif)
~10
## Limites à respecter
- Ne PAS soumettre de formulaire pour de vrai (pas de compte, pas de paiement).
- Rester en lecture/navigation : aucune action destructrice.Deux choses comptent : la spec (ou « aucune ») et les limites. Les limites sont sacrées, c’est ce qui empêche l’agent d’envoyer un vrai formulaire de contact ou de déclencher un paiement. Si tu n’en précises pas, l’agent reste par défaut en lecture/navigation, sans rien casser.
⚠️ Ce projet est modulable. Si quelque chose n’est pas fait comme tu le souhaites, si tu as des besoins spécifiques, demande-lui ce qui doit être modifié dans le projet, il saura faire les ajustements nécessaires.
Étape 3 – La programmation (/plan)
Première phase. Claude lit cible.md, explore le site dans le navigateur, et écrit un plan dans plan-de-test.md. Il ne lance aucun test ici : il observe et planifie.
Cette phase devrait se lancer automatiquement, si ce n’est pas le cas, demande -le à Claude
Résultat : un plan numéroté, lisible, du genre T01 — La page d'accueil se charge, avec objectif, étapes et résultat attendu.
💡 Pourquoi séparer plan et exécution ? Parce que le plan est un artefact qu’un humain relit et corrige avant de lancer les tests. C’est ce qui rend le système auditable plutôt qu’une boîte noire.
Étape 4 – L’exécution (/test)
Deuxième phase. Claude joue chaque test du plan dans le navigateur, prend une capture-preuve par test, et écrit un verdict honnête dans resultats.md.
Les trois règles d’or de cette phase :
- Aucun verdict sans preuve : une observation factuelle + une capture.
- Honnêteté : s’il ne peut pas trancher (page ambiguë, bloquée, hors périmètre), c’est 🟠 « à vérifier », jamais un 🟢 de complaisance.
- Doute de toi : avant de crier au bug, vérifier que ce n’est pas un faux positif (image en lazy-loading, élément hors écran…).
Ce 🟠, c’est le cœur de l’honnêteté du système. Un testeur qui invente des « OK » est pire qu’inutile. Ici, l’incertitude est un statut de première classe.
Étape 5 – Le rapport (/rapport)
Troisième phase : Claude code va transformer resultats.md + les captures en un rapport autonome (un seul fichier, captures intégrées, ouvrable hors ligne).
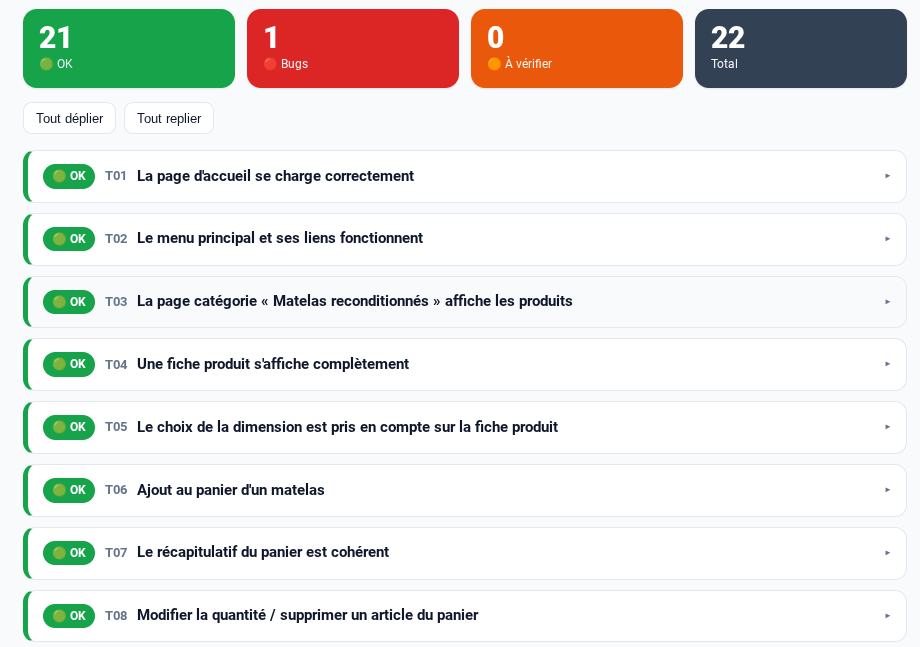
⚠️ La leçon la plus importante du projet. J’ai d’abord demandé à Claude de générer lui-même le HTML du rapport. Mauvaise idée : encoder 20+ captures en base64 dans un seul appel, c’est trop lourd — la phase « échouait » en silence et laissait un vieux rapport en place. La bonne approche : générer le rapport de façon déterministe avec un script Node. Fiable à 100 %, et ça libère l’IA des tâches mécaniques pour lesquelles elle n’apporte rien.
Le script construire-rapport.mjs lit le Markdown des résultats, encode les captures, et produit une scorecard (compteurs 🟢/🔴/🟠) plus une carte-accordéon par test : en-tête cliquable, chevron qui pivote, bugs ouverts par défaut. Le lecteur déplie ce qui l’intéresse.
Règle générale à retenir : fais faire à l’IA ce qui demande du jugement (explorer, juger un verdict), et au code ce qui demande de la fiabilité (assembler un fichier).
Étape 6 – Tout enchaîner (lancer.mjs)
Pour ne plus rien taper à la main, tu peux demander à claude code de lancer tous les processus (node lancer.mjs)
Le script enchaîne les phases IA (plan → test) en mode non interactif, puis génère le rapport en local, additionne les tokens consommés, et archive le rapport de chaque passage dans son propre dossier :
runs/
├── monsite_2026-06-01_15-11/rapport.html
└── maboutique_2026-05-28_09-30/rapport.html
Le « sujet » (monsite, maboutique) est déduit automatiquement de l’URL, et la date-heure évite d’écraser un passage précédent. Tu gardes ainsi un historique par site, dans le temps.
Bonus : le faire tourner chaque jour
Comme c’est une seule commande, tu peux demander à claude code de te faire un cron, pour une surveillance quotidienne par exemple.
Les pièges que tu éviteras (et que j’ai rencontrés)
- Le rapport « généré » mais périmé → génération déterministe par script, pas par l’IA (Étape 6).
- Les fichiers qui s’écrasent → un dossier
runs/<sujet>_<date>/par passage (Étape 7). - Les déchets qui s’accumulent (logs MCP, dumps de snapshots) → un nettoyage automatique en fin de run et un
.gitignore.
Ce que ça change
En une commande, j’ai un testeur qui :
- explore un site qu’il ne connaît pas,
- planifie une couverture pertinente,
- exécute dans un vrai navigateur,
- et rend un verdict prouvé, pas bluffé.
Le tout reste local et auditable : le plan se relit, les verdicts s’appuient sur des captures, et chaque passage est archivé. Autonome, mais sous contrôle.
Le code complet (commandes + scripts) tient dans un dossier que tu peux cloner et lancer en 15 minutes. C’est exactement l’esprit de Qanary : des tests sérieux, sans la friction.
Honnêtement : quand l’utiliser… et quand préférer une plateforme
Soyons clairs sur le bon usage, parce que c’est là que tout se joue.
1. Parfait pour explorer, moins pour automatiser le même scénario chaque jour
Cet agent brille pour une chose : l’exploration. Découvrir un site, balayer large, vérifier les fondamentaux, lever des doutes, c’est là qu’il est imbattable, parce qu’il comprend ce qu’il voit et s’adapte tout seul.
En revanche, pour de l’automatisation précise et répétée, rejouer chaque jour exactement le même scénario de non-régression, une plateforme dédiée comme Qanary est plus pertinente. Tu ne veux pas qu’un test « réfléchisse » à nouveau chaque matin : tu veux qu’il reproduise le scénario à l’identique, vite et de façon déterministe. Un agent qui réinterprète la page à chaque passage, c’est génial pour découvrir… et contre-productif quand tu cherches la stabilité.


